Управление знаниями с решениями TerraLink на базе платформы OpenText
26.09.2018
Процесс управления знаниями
Все хотят пользоваться базами знаний, но никто не хочет их наполнять. К сожалению, большинство людей не делится своими знаниями. Точнее они как-то ими делятся, но никак не хотят их формализовать. Ведь написать что-то в чате или по электронной почте гораздо проще, чем перейти в корпоративную базу знаний (например, wiki), создать статью или исправить существующую. Таким образом, мы видим или отсутствие мотивации делиться знаниями, или, даже мотивацию НЕ делиться знаниями, если сотрудники конкурируют друг с другом (например, в отделе продаж). Как можно решить эту проблему? Возможно, разработать программу мотивации? Например, выдавать премию за каждую созданную статью в wiki? Или мы все-таки можем каким-то образом автоматизировать этот процесс?
Антон Рождественский
Ведущий консультант по
управлению данными
TerraLink
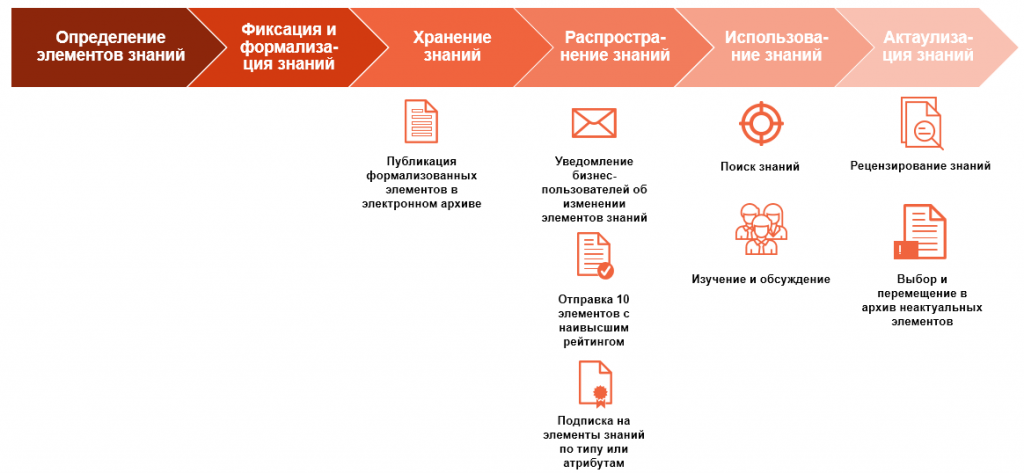
На этой схеме рассмотрен процесс управления знаниями. Он начинается с идентификации элемента знаний, его фиксации и формализации в стандартном представлении. Затем мы должны определить, где его хранить, какое место будет лучшим, чтобы все заинтересованные лица его увидели. И здесь возникает еще одна проблема в управлении знаниями: как правильно уведомить бизнес-пользователей, как сказать: «Обратите внимание на этот документ, он очень важен!» Или: «Этот документ также важен, но не критичен». Следующий шаг – использование знаний. Все заинтересованные сотрудники должны иметь возможность предоставить обратную связь. Был ли данный элемент знаний полезен для них? Возможно, у них есть идея, как его можно улучшить. И последний, но важный момент – это актуализация знаний. Все, и особенно новые бизнес-пользователи, которые только начинают работать в своей области, должны знать, является ли это знание актуальным, могут ли они использовать его в своей работе, могут ли они ему доверять? Если нет, то этот элемент знаний должен быть проверен или помещен в архив.
Тайные знания
Приведем пример из производственной сферы. Конечно, вы знаете, сколько разных документов связано с промышленным оборудованием. Это может быть тендерная документация, заказ на поставку, эксплуатационная документация, ремонтная документация и т. д. Но вот вопрос: «Как часто во время эксплуатации что-то происходит не так?» Вы открываете нужный документ и видите фразу типа «Если что-то не работает, обратитесь к производителю». Существует много вариантов, почему что-то может пойти не так, и вам нужно подождать, пока кто-то от производителя приедет к вам и решит проблему. Да, возможно, он объяснит вашим инженерам, что случилось, но они могут забыть об этом решении или просто уволиться. А новые инженеры или инженеры из другого филиала не будут знать об этой проблеме вообще. И история повторится.
Итак, как же преобразовать скрытые знания в стандартное решение, о котором все знают? Предположим, что инженер с одной смены не сообщил своему коллеге со следующей смены о проблеме с запуском новой турбины. Инженер второй смены прочитал все руководства и пробовал им следовать, но по каким-то причинам это не сработало. И тогда он решил написать электронное письмо своему коллеге с вопросом, как он решает эту проблему. Коллега подсказал ему решение, и все сработало отлично. Но каковы шансы, что завтра эта проблема снова не появится? И снова никто не будет знать, что делать. Итак, нам нужно зафиксировать это знание, классифицировать и опубликовать его.
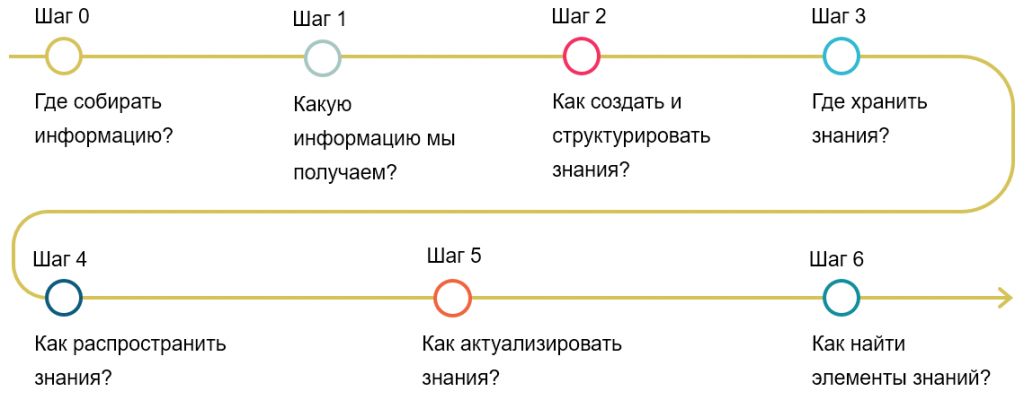
Вот вопросы, на которые нужно ответить. Мы должны найти источники, из которых мы можем получить информацию. Мы должны знать, какую информацию мы действительно получаем, как ее структурировать, и где ее хранить. Как ей делиться, и как ее актуализировать? Как мы можем ее найти?
Как использовать знания?
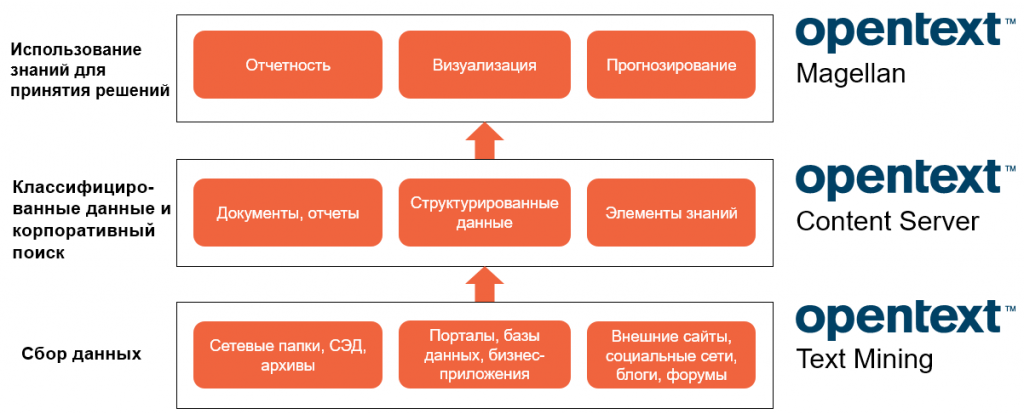
Эта схема описывает, какие продукты OpenText могут помочь нам в управлении знаниями. Ключевой продукт – это OpenText Text Mining, который позволяет сделать первый шаг в сборе знаний. Content Server помогает создавать элементы знаний, структурировать и хранить их. Magellan будет визуализировать предметы знаний с помощью разных моделей отчетов и прогнозов.
- Где собирать информацию?
Где мы можем собирать знания? Продукт Text Mining может быть интегрирован с различными веб-сайтами, например, форумами, на которых сотрудники обсуждают конкретные вопросы. Мы можем использовать их знания и опыт. Также мы можем получить обновления официальной документации поставщиков. В компании много разных хранилищ ECM - мы можем собрать информацию из них всех.
- Какую информацию мы получаем?
После установления связи с источниками мы начнем получать разные данные. Поэтому давайте преобразуем их в информацию. Но прежде всего нам нужно знать, какие данные мы только что получили. Text Mining помогает нам и в этом. Он может искать текст и находить имена людей, которые участвуют в обсуждении, темы обсуждения и другие метаданные. Имея метаданные, мы можем управлять потоками данных и направить данные к нужному менеджеру знаний – сотруднику, который компетентен в этой области.
- Как создать знания?
После классификации информации, мы должны решить, полезная ли это информация и актуальна ли она. Владелец базы знаний вместе с менеджерами знаний, компетентными в этой области, совместно принимают это решение.
- Как структурировать знания?
Итак, мы собрали информацию из разных источников и создали структурированный и релевантный элемент знаний. Теперь нам нужно его классифицировать. OpenText Content Server может ее проанализировать и найти ключевые слова и смысл текста. Мы также можем разделить элементы знаний по типу документов и источников.
- Где хранить знания?
Благодаря метаданным, мы можем определить, какая папка будет оптимальной для хранения нового элемента знаний.
- Как распространить знания?
Итак, элемент знаний создан. Теперь мы должны поделиться им со всеми заинтересованными сотрудниками. Все они имеют свои роли, и система понимает, какие знания, вероятно, будут для них полезны. Таким образом, они могут автоматически получать новые знания и оценивать их. В случае положительной оценки элемента знаний пользователями, система повышает его рейтинг, что приводит к еще более широкому распространению данного элемента в организации.
- Как актуализировать знания?
Также время от времени мы должны спрашивать заинтересованных людей, является ли эта информация полезной, актуальной и релевантной для них. Если ответ «нет», то давайте поместим ее в архив. Или, может быть, она может быть актуализирована.
- Как найти элементы знаний?
Важно иметь возможность найти элементы знаний. Content Server индексирует все файлы, чтобы мы могли искать необходимую информацию с помощью тегов метаданных или содержимого документа.
Будем рады, если наш материал поможет вам в превращении вашей компании в организацию знаний. А также с радостью продемонстрируем вам возможности решений TerraLink на базе платформы OpenText.
О компаниях OpentText и TerraLink: Компания OpenText, основанная в 1991 году в Канаде, является одним из крупнейших мировых производителей решений для управления корпоративным контентом. Компания TerraLink более 15 лет работает с продуктами OpenText, имеет высший Платиновый партнерский статус и неоднократно получала награды за свои достижения.